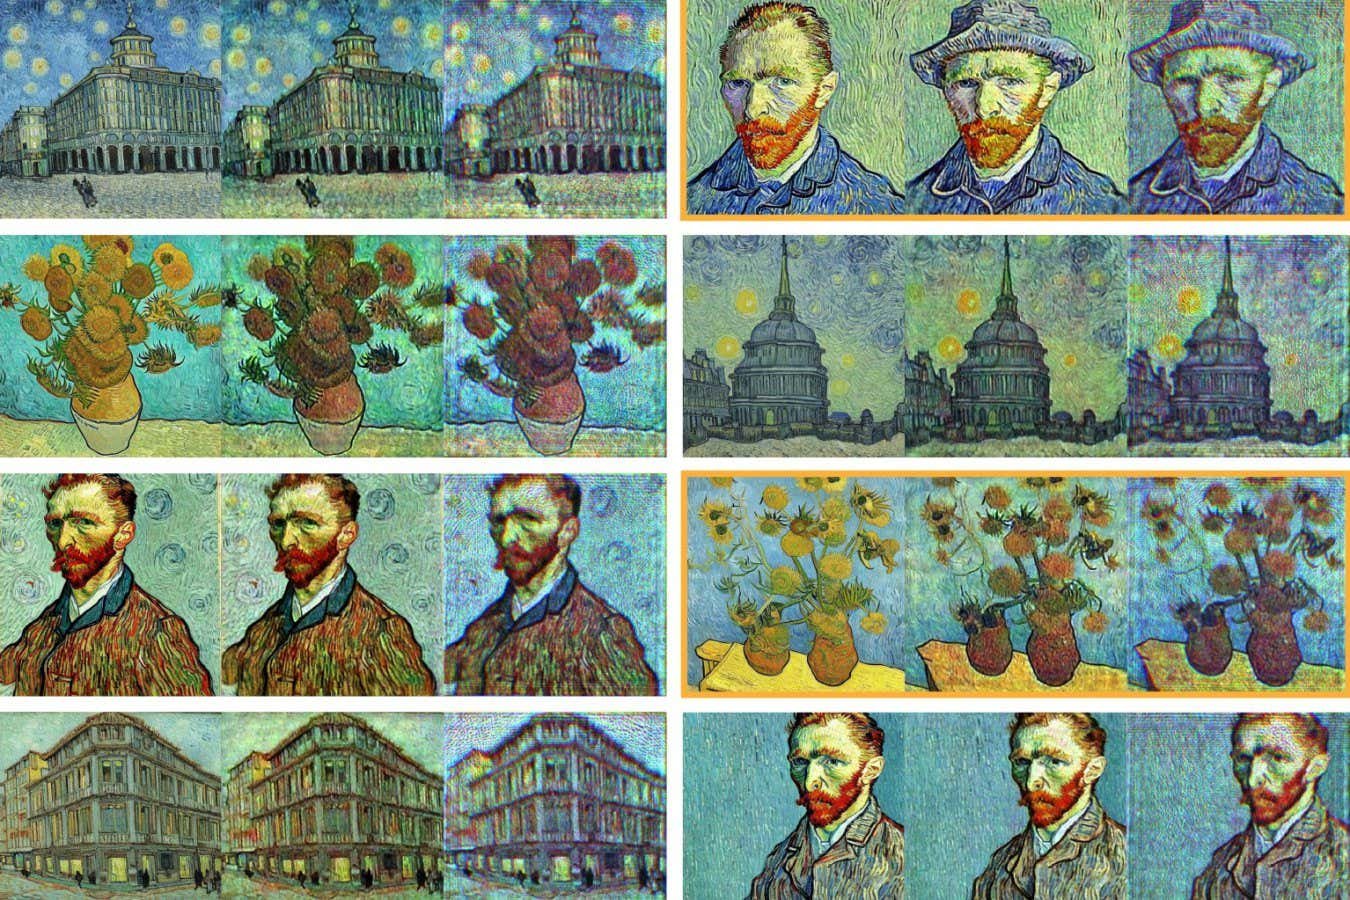
傳統傳播模型(每三組剩下)和光學圖像發生器(右)生產的色彩豐富的Vincent Van Goh風格的文物(右)
Shiki Chen等。 2025
AI圖像生成器使用光來創建圖像而不是傳統的計算硬件,可以減少數百倍的功率。
當人工智能模型從文本中產生圖像時,通常使用稱為擴散的過程。首先向AI顯示了大量圖像集合,並顯示出使用統計聲音銷毀它們,然後在一組規則中編碼了這些設計。當給出新的嘈雜圖像時,它可以用來反向做同樣的事情:在大多數步驟中,它用於適合給定文本請求的連貫膜。
對於真實的高分辨率圖像,擴展使用了幾個需要大量計算能力的步驟。在四月, OpenA報導 它的新圖像生成器在第一周創建了超過7億張圖像。該量表需要大量的能量和水來滿足需求並冷卻運行模型的機器。
現在, 艾達·奧茲坎(Idogan Ozkan) 在加利福尼亞大學,洛杉磯和他的同事開發了一個基於擴展的圖像生成器,該生成器使用光束工作。如果編碼過程是數字化的,則需要少量的能量,則解碼過程是完全光的,不需要計算能力。
Ozkan說:“與需要數百到數千個重複性步驟的數字擴散模型不同,此過程可以在快照中實現膜的產生,並且不需要早期編碼以外的其他計算。”
該系統首先使用訓練有素的數字編碼器使用圖像數據集,該數據集可產生可以轉換為圖像的靜態。然後,他們將此編碼器與稱為“區域光調節器”(SLM)的液晶屏幕使用,該屏幕可以將該靜態靜電在激光束中。當激光光束穿過第二個解碼SLM時,它立即在相機記錄的屏幕上產生所需的圖片。
Ozcon和他的小組被用來創建簡單物品的黑白圖像,例如1至9位數字或基本禮服,用於測試爆發模式,以及Vincent Van Goh風格的全彩色圖像。結果看起來與傳統圖像發生器生成的結果相似。
“這可能是光學神經網絡的第一個示例,不僅是實驗室玩具,而且只有可以產生實際價值結果的計算工具” 亞歷山大·利沃夫斯基(Alexander Lvovsky) 在牛津大學。
對於Van Goh風格的圖像,該系統僅對每部電影消耗幾毫秒的功率,主要用於液晶屏幕,而數百或數千種傳統的擴展設計。 Lvovsky說:“考慮到這一點,第二個等於第二次消耗的電量,但光學機器消耗適用於第二次。”
Ozkan說,儘管需要採用該系統在數據中心使用廣泛使用的圖像生成工具,但由於低功率要求而可以用作AI眼鏡的電子設備中的用途。
事物: